blog.Ring.idv.tw

Articles

淺談Hadoop FileSystem API

在Hadoop中,我們若是想直接存取HDFS之中的資料或進行一些檔案的操作,可以透過它所提供的FileSystem API來達成,下述程式是一個簡單範例:

import java.io.IOException;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FileSystem;

public class GetFileSystem
{
	public static void main(String[] args) throws IOException
	{
		String uri = "hdfs://shen:9000/user/";
		Configuration conf = new Configuration();
		FileSystem fs = FileSystem.get(URI.create(uri), conf);
	}
}

上述程式在執行的過程會執行三次的shell command,分別為:

whoami
bash -c groups
whoami

而內部的運作方式,是當上述程式執行「FileSystem.get()」方法之後,它會利用FileSystem類別本身的一個static物件「FileSystem.Cache」(如下述程式),去執行所屬的「FileSystem.Cache.get()」方法,並透過Map去找尋是否有Cache住的FileSystem instance,所以在找尋的過程中會產生一個「FileSystem.Cache.Key」物件,而它的Constructor會呼叫「UserGroupInformation.login()」靜態方法,並再交由「UnixUserGroupInformation.login()」去執行登入的動作,而這個登入的動作就會透過「org.apache.hadoop.util.Shell」去執行上述「whoami」和「bash -c groups」兩個指令。

FileSystem.java (lines:1382~1397)

static class Cache {
    private final Map<Key, FileSystem> map = new HashMap<Key, FileSystem>();

    synchronized FileSystem get(URI uri, Configuration conf) throws IOException{
      Key key = new Key(uri, conf);
      FileSystem fs = map.get(key);
      if (fs == null) {
        fs = createFileSystem(uri, conf);
        if (map.isEmpty() && !clientFinalizer.isAlive()) {
          Runtime.getRuntime().addShutdownHook(clientFinalizer);
        }
        fs.key = key;
        map.put(key, fs);
      }
      return fs;
    }

那為何又會有第三個「whoami」指令?

這是因為如果從Cache中找不到對應的FileSystem的話,它會執行「private static createFileSystem()」方法去產生一個對應的FileSystem instance,並執行一些初始化的動作(如下述程式),而如何產生對應的FileSystem會取決於URI scheme來決定,由於上述的範例是要存取HDFS,所以scheme為hdfs,並經由「$HADOOP_HOME/src/core/core-default.xml」的組態檔可得知,HDFS對應的FileSystem class是「org.apache.hadoop.hdfs.DistributedFileSystem」(它繼承於FileSystem),所以重點就在於此類別中的「initialize()」所為何事?

FileSystem.java (lines:1369~1379)

private static FileSystem createFileSystem(URI uri, Configuration conf
      ) throws IOException {
	  LOG.warn(uri.getScheme());
    Class<?> clazz = conf.getClass("fs." + uri.getScheme() + ".impl", null);
    if (clazz == null) {
      throw new IOException("No FileSystem for scheme: " + uri.getScheme());
    }
    FileSystem fs = (FileSystem)ReflectionUtils.newInstance(clazz, conf);
    fs.initialize(uri, conf);
    return fs;
  }

在「org.apache.hadoop.hdfs.DistributedFileSystem」中執行「initialize()」方法會產生一個「org.apache.hadoop.hdfs.DFSClient」物件,它準備用來和HDFS進行連線的工作,而它的Constructor又會呼叫「UnixUserGroupInformation.login()」去執行登入的動作,所以才又有第二次的「whoami」指令,那為何第二次沒有執行「bash -c groups」指令?這是因為「UnixUserGroupInformation」本身也會Cache,所以執行第二次的「whoami」指令主要就是要從Cache中再取出「UnixUserGroupInformation」並傳回給「org.apache.hadoop.hdfs.DFSClient」,之所以如此才會依序執行「whoami」、「bash -c groups」和「whoami」三個指令,所以其實HDFS純粹透過Shell來取得使用者的身份和群組資訊。

UnixUserGroupInformation.java (lines:238~277)

public static UnixUserGroupInformation login() throws LoginException {
    try {
      String userName;

      // if an exception occurs, then uses the
      // default user
      try {
        userName =  getUnixUserName();
      } catch (Exception e) {
        userName = DEFAULT_USERNAME;
      }

      // check if this user already has a UGI object in the ugi map
      UnixUserGroupInformation ugi = user2UGIMap.get(userName);
      if (ugi != null) {
        return ugi;
      }

      /* get groups list from UNIX. 
       * It's assumed that the first group is the default group.
       */
      String[]  groupNames;

      // if an exception occurs, then uses the
      // default group
      try {
        groupNames = getUnixGroups();
      } catch (Exception e) {
        groupNames = new String[1];
        groupNames[0] = DEFAULT_GROUP;
      }

      // construct a Unix UGI
      ugi = new UnixUserGroupInformation(userName, groupNames);
      user2UGIMap.put(ugi.getUserName(), ugi);
      return ugi;
    } catch (Exception e) {
      throw new LoginException("Login failed: "+e.getMessage());
    }
  }

2010.01.04 updated

.HADOOP-4998在討論是否實作一個native OS runtime for Hadoop,如此就不用依賴上述Shell command來取得OS的相關資源.

Bash -c string 說明

來源:bash(1) - Linux man page

If the -c option is present, then commands are read from string. 
If there are arguments after the string, they are assigned to the positional parameters, starting with $0. 
2009-11-26 23:55:07 | Add Comment

Google Translate 整合 Text-to-Speech 技術

今天Google的官方部落格發表了一篇:「A new look for Google Translate」,除了使用性上的改善之外,最讓我感興趣的是它Text-to-Speech(TTS)技術的整合。

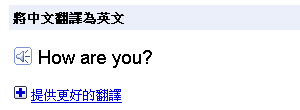
現在可以在Google Translate下輸入任何原文,並將譯文選擇為「英文」,便可以使用這樣的服務,不過在筆者的測試下,如果譯文過長的話將不會提供TTS服務。

由於此服務是藉由它頁面上的「sound_player.swf」來載入一個外部MP3格式的音訊檔,至於這個音訊檔的載入位置... 筆者的發現如下:

http://translate.google.com.tw/translate_tts?q=How are you?&tl=en

也就是說,如果你想要藉由Google的TTS技術來動態播放的話,那就將上述網址的「q」參數值變化一下即可。

P.S. 如此「TransNote」的整合就只剩下時間的問題而已了。

2009-11-17 20:56:39 | Add Comment

QuickDict - 快速查詢單字的書籤小程式

.2011/08/16 新增「Oxford Advanced Learner's Dictionary」字典
.2011/08/16 新增「Merriam-Webster.com」字典
.2011/08/16 移除「Google」字典
.2009/11/16 移除「Dr.eye」,並改使用「沪江小D」字典
.2009/11/16 新增「Dictionary.com」字典

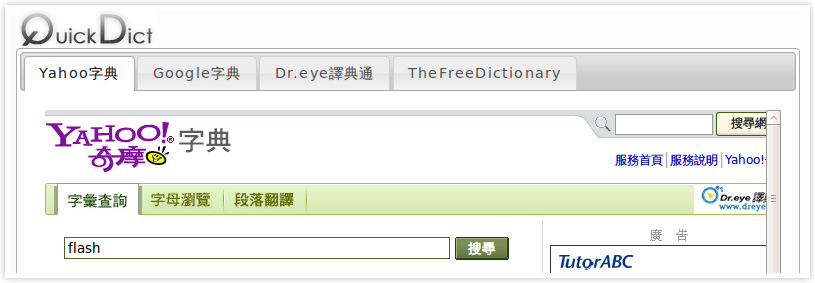
QuickDict.是一個結合Yahoo、Google、沪江小D和TheFreeDictionary.com等字典的書籤小程式。

使用的方式相當簡單,首先進到「QuickDict」的頁面之後,將左上角QuickDict的Bookmarklet加到你的最愛,接下來就可以直接使用了!

使用方式

使用的方式有兩種,第一種是當你在網頁上選取某個英文單字之後,接著點擊這一個「QuickDict書籤]」,該程式就會將您所選取的英文單字,同時傳遞到上述四個網站進行查詢,並透過頁籤的方式呈現。

另一種使用方式則是當您「沒有選取任何單字」時,若是直接點擊此「QuickDict書籤」,此程式會自動提示一個文字輸入框供您輸入單字,按下「Enter」之後就會開始進行查詢。

後記

由於只花了一點時間來完成這個小東西,所以若是有任何問題或建議的話,可以直接留言給我,筆者會加以改善的,謝謝。

P.S. 眼尖的人應該會發現「QuickDict」的「Q」,筆者故意將它反轉 :D

2009-11-01 23:00:13 | Comments (15)

TFile - A new binary file format for Hadoop

在Hadoop 0.20.1版本釋出後,它多了一個名為「TFile」的Binary File Format,因為當初設計「SequenceFile」的Block Compression格式過於複雜,所以重新設計了這個「TFile」檔案格式,同時它也俱備了較佳的效能、可擴充性和語言的中立性(意指不會看到Java中的package名稱,可參考筆者先前po文「Hadoop - Uncompressed SequenceFile Format 詳解」),更多的詳細細節可參考HADOOP-3315。

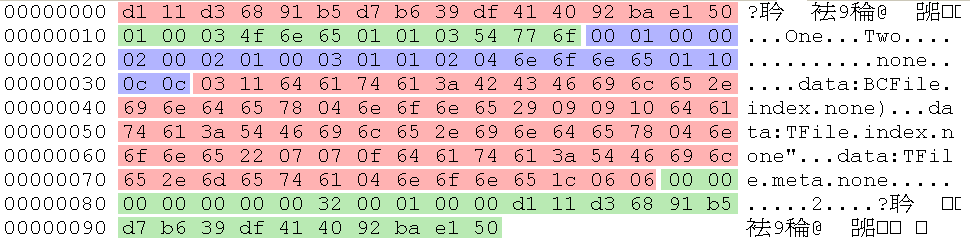
基本上一個TFile storage format是由兩個部份所組成的:一個是Block Compressed File layer (簡稱BCFile),另一個為TFile-specific <key,value> management layer(這部份未來也許會逐漸地擴充)。而一個BCFile storage layout是由五個部份所組成,它們分別為:

(1)a 16-byte magic.

(2)a data section that consists of a sequence of Data Blocks.

(3)a meta section that consists of a sequence of Meta Blocks.

(4)a Meta Block index section (“Meta Index”).

(5)a tail section.

這裡筆者直接測試一個範例:

import java.io.IOException;
import java.net.URI;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FSDataOutputStream;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.file.tfile.TFile;

public class TFileWriter
{
	private static final String[] DATA = {"One","Two"};

	public static void main(String[] args) throws IOException
	{
		String uri = "hdfs://shen:9000/user/shen/test.tfile";
		Configuration conf = new Configuration();
		FileSystem fs = FileSystem.get(URI.create(uri), conf);
		fs.delete(new Path("test.tfile"), true);
		
		Path path = new Path(uri);
		FSDataOutputStream fdos = fs.create(path, true);
	
		TFile.Writer writer = new TFile.Writer(fdos, 1024*128, TFile.COMPRESSION_NONE, null , conf);
		
		for (int i = 0; i < DATA.length; i++)
		{		
			writer.append(new byte[]{(byte)i}, DATA[i].getBytes());
		}

		writer.close();
	}
}

在這個範例中只會有兩筆Record,它們分別為:<0,'One'>和<1,'Two'>,最後輸出成TFile檔案格式,如下圖:

P.S. 下圖筆者用「紅→綠→藍」顏色區隔BCFile storage layout所組成的五個部份。

2009-10-31 15:57:23 | Add Comment

Sqoop: A database import tool for Hadoop

Sqoop("SQL-to-Hadoop").簡單來說它是用來協助開發人員將資料庫的資料轉換到HDFS的一項工具,不過要到Hadoop 0.21.0版本釋出才會正式的納進來,但如果現在就要使用的話可以直接Patch HADOOP-5815來使用。

Sqoop主要是透過JDBC來和各個資料庫連結,並自動產生O/R Mapping的java檔,最後透過MapReduce將資料庫的資料轉換到HDFS之中,下述是筆者的範例測試:

Sqoop example for MySQL

下載JDBC Driver for MySQL (Connector/J 5.1),並設定好它的CLASSPATH。

資料庫: test

資料表: student

create table student(
    id int not null primary key,
    name varchar(20),
    score tinyint
);

預設三筆資料:

mysql> select * from student;
+----+------+-------+
| id | name | score |
+----+------+-------+
|  1 | mary |    98 |
|  2 | jack |    94 |
|  3 | john |    40 |
+----+------+-------+
3 rows in set (0.00 sec)

這裡的目標是指定將student table轉出到HDFS之中:

hadoop jar sqoop.jar org.apache.hadoop.sqoop.Sqoop --connect jdbc:mysql://localhost/test --table student

執行過程:

09/10/30 06:48:47 INFO sqoop.Sqoop: Beginning code generation
09/10/30 06:48:48 INFO manager.SqlManager: Executing SQL statement: SELECT t.* FROM student AS t WHERE 1 = 1
09/10/30 06:48:48 INFO orm.CompilationManager: HADOOP_HOME is /home/hdp/hadoop-0.20.1/bin/..
09/10/30 06:48:48 INFO orm.CompilationManager: Found hadoop core jar at: /home/hdp/hadoop-0.20.1/bin/../hadoop-0.20.1-core.jar
09/10/30 06:48:48 INFO orm.CompilationManager: Invoking javac with args: -sourcepath ./ -d /tmp/sqoop/compile/ -classpath /home/hdp/hadoop-0.20.1/bin/../conf:/usr/lib/jvm/java-6-sun-1.6.0.10/lib/tools.jar:/home/hdp/hadoop-0.20.1/bin/..:/home/hdp/hadoop-0.20.1/bin/../hadoop-0.20.1-core.jar:/home/hdp/hadoop-0.20.1/bin/../lib/commons-cli-1.2.jar:/home/hdp/hadoop-0.20.1/bin/../lib/commons-codec-1.3.jar:/home/hdp/hadoop-0.20.1/bin/../lib/commons-el-1.0.jar:/home/hdp/hadoop-0.20.1/bin/../lib/commons-httpclient-3.0.1.jar:/home/hdp/hadoop-0.20.1/bin/../lib/commons-logging-1.0.4.jar:/home/hdp/hadoop-0.20.1/bin/../lib/commons-logging-api-1.0.4.jar:/home/hdp/hadoop-0.20.1/bin/../lib/commons-net-1.4.1.jar:/home/hdp/hadoop-0.20.1/bin/../lib/core-3.1.1.jar:/home/hdp/hadoop-0.20.1/bin/../lib/hsqldb-1.8.0.10.jar:/home/hdp/hadoop-0.20.1/bin/../lib/jasper-compiler-5.5.12.jar:/home/hdp/hadoop-0.20.1/bin/../lib/jasper-runtime-5.5.12.jar:/home/hdp/hadoop-0.20.1/bin/../lib/jets3t-0.6.1.jar:/home/hdp/hadoop-0.20.1/bin/../lib/jetty-6.1.14.jar:/home/hdp/hadoop-0.20.1/bin/../lib/jetty-util-6.1.14.jar:/home/hdp/hadoop-0.20.1/bin/../lib/junit-3.8.1.jar:/home/hdp/hadoop-0.20.1/bin/../lib/kfs-0.2.2.jar:/home/hdp/hadoop-0.20.1/bin/../lib/log4j-1.2.15.jar:/home/hdp/hadoop-0.20.1/bin/../lib/oro-2.0.8.jar:/home/hdp/hadoop-0.20.1/bin/../lib/servlet-api-2.5-6.1.14.jar:/home/hdp/hadoop-0.20.1/bin/../lib/slf4j-api-1.4.3.jar:/home/hdp/hadoop-0.20.1/bin/../lib/slf4j-log4j12-1.4.3.jar:/home/hdp/hadoop-0.20.1/bin/../lib/sqoop.jar:/home/hdp/hadoop-0.20.1/bin/../lib/xmlenc-0.52.jar:/home/hdp/hadoop-0.20.1/bin/../lib/jsp-2.1/jsp-2.1.jar:/home/hdp/hadoop-0.20.1/bin/../lib/jsp-2.1/jsp-api-2.1.jar:.:/home/hdp/hadoop-0.20.1/bin/../mysql-jdbc.jar:/home/hdp/hadoop-0.20.1/bin/../hadoop-0.20.1-core.jar ./student.java
09/10/30 06:48:49 INFO orm.CompilationManager: Writing jar file: /tmp/sqoop/compile/student.jar
09/10/30 06:48:49 INFO mapred.ImportJob: Beginning data import of student
09/10/30 06:48:50 INFO manager.SqlManager: Executing SQL statement: SELECT t.* FROM student AS t WHERE 1 = 1
09/10/30 06:48:50 INFO mapred.JobClient: Running job: job_200910300539_0002
09/10/30 06:48:51 INFO mapred.JobClient:  map 0% reduce 0%
09/10/30 06:49:04 INFO mapred.JobClient:  map 50% reduce 0%
09/10/30 06:49:07 INFO mapred.JobClient:  map 100% reduce 0%
09/10/30 06:49:09 INFO mapred.JobClient: Job complete: job_200910300539_0002
09/10/30 06:49:09 INFO mapred.JobClient: Counters: 6
09/10/30 06:49:09 INFO mapred.JobClient:   Job Counters
09/10/30 06:49:09 INFO mapred.JobClient:     Launched map tasks=2
09/10/30 06:49:09 INFO mapred.JobClient:   FileSystemCounters
09/10/30 06:49:09 INFO mapred.JobClient:     HDFS_BYTES_WRITTEN=30
09/10/30 06:49:09 INFO mapred.JobClient:   Map-Reduce Framework
09/10/30 06:49:09 INFO mapred.JobClient:     Map input records=3
09/10/30 06:49:09 INFO mapred.JobClient:     Spilled Records=0
09/10/30 06:49:09 INFO mapred.JobClient:     Map input bytes=3
09/10/30 06:49:09 INFO mapred.JobClient:     Map output records=3

在執行Sqoop上述指令後,它會自動產生一個「student.java」檔(ORM),並打包在「/tmp/sqoop/compile/student.jar」,而這個檔案除了包含「student.class」,同時也包含「sqoop.jar」在它的lib資料夾內,執行成功之後就可以在HDFS之中看到轉換後的資料。

從上述的執行過程中,不難發現其實Sqoop只是透過Map Phase來進行轉換。

相關資源

.Introducing Sqoop

.Getting Started With Sqoop

.Sqoop

2009-10-30 19:20:01 | Comments (4)

Next Posts~:::~Previous Posts
Copyright (C) Ching-Shen Chen. All rights reserved.

::: 分類 :::

::: 最新文章 :::

::: 最新回應 :::